Содержание3 разделов
В архиве лежит заметка про замену аккумулятора, а вы ищете «телефон быстро разряжается». Эти формулировки связаны, но слова совпадают слабо. Для подобных запросов используют поиск по смыслу с помощью embeddings.
Текст получает числовое представление
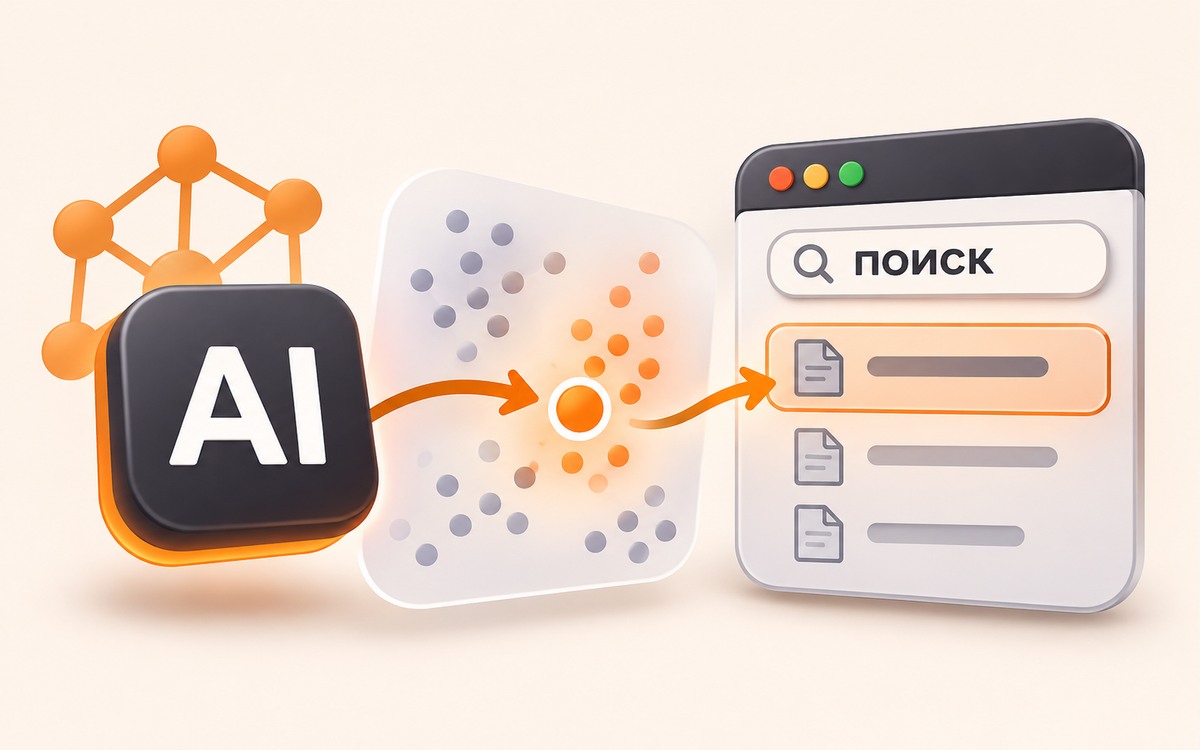
Embedding представляет текст в виде вектора, то есть набора чисел. По близости таких наборов система подбирает подходящие фрагменты. В документации Ollama этот механизм описан для семантического поиска и извлечения материалов. Для индексации и запросов нужна одна и та же embedding-модель.
Практическая цепочка выглядит так: фрагменты архива получают числовые представления, затем такое представление получает запрос. Система сравнивает их и возвращает кандидатов для чтения. Ответ в этом случае состоит из найденных документов. Отдельный чат-бот для первого опыта не обязателен.
Сначала сравните с обычным поиском
Возьмите небольшой архив без чувствительных сведений. Составьте несколько вопросов, для которых вы заранее знаете нужные документы. Для каждого попробуйте точные слова и бытовую формулировку. Затем сравните верхние результаты двух способов поиска.
Это редакционная рекомендация по проверке, а не обещание качества любой модели. Подходящий материал должен появляться достаточно высоко, чтобы вы его заметили. Если он постоянно теряется среди общих советов, красивый интерфейс проблему не решает.
Похожая тема не гарантирует нужный ответ
Две заметки могут относиться к батареям и отвечать на разные вопросы. Одна объясняет режим энергосбережения, другая описывает замену детали. Поэтому найденному фрагменту нужны понятный заголовок и ссылка на оригинал. Читатель должен иметь возможность проверить контекст.
Поиск номера заказа или точного имени файла стоит проверять отдельно. Тут буквальное совпадение может быть важнее тематической близости. Не убирайте прежний поиск, пока не сравнили оба способа на своих запросах.
Embeddings могут стать частью системы RAG, где найденные фрагменты передают модели для ответа. Но хороший поиск полезен и сам по себе. Начните с выдачи документов, проверьте попадания и только потом добавляйте генерацию текста.
Число рядом с найденным фрагментом требует отдельного прочтения: проверьте метрику score и отличие похожести от уверенности в ответе. Порог подбирают на своих вопросах и документах.
Источники

Как вам материал?
Комментарии